

에이전트 거버넌스 설계: Anthropic 에이전트 3만 개 감시 구조에서 배우는 4가지
에이전트 파일럿이 세 개일 때는 별문제가 없습니다. 담당자가 매일 결과를 열어 보고, 이상하면 바로 멈추면 됩니다. 그런데 부서마다 에이전트를 도입하기 시작해 수십 개가 되면 질문이 달라집니다. 지난주에 어떤 에이전트가 어느 시스템에 무엇을 썼는지, 그중 사람이 확인한 건 몇 건인지. 로그는 어딘가에 쌓이고 있는데 이 질문에 바로 답하는 팀은 드뭅니다.
에이전트를 몇 개 돌리느냐보다 무엇을 기준으로 막고, 누가 언제 들여다보느냐를 먼저 정해야 합니다. 이런 구조를 에이전트 거버넌스라고 부르는데, 최근 이 구조를 실제 숫자와 함께 공개한 곳이 나왔습니다.
Anthropic이 공개한 숫자
Anthropic은 2026년 9월 17일 "Measurements for understanding the pace of AI development inside frontier labs"라는 글에서 사내 지표를 공개했습니다.
첫째, 2026년 8월 기준으로 Anthropic 사내 AI 연구개발 업무의 26%를 Claude가 "주도(leads)"합니다. 사람이 큰 방향만 잡아 주면 Claude가 작업 대부분을 끝까지 처리하고, 사람은 감독을 맡는 수준입니다. 함께 공개한 차트를 보면 같은 해 2월만 해도 이 비율은 1%에 못 미쳤습니다. 다만 사람 없이 완전히 자율로 돌아가는 영역은 측정 범위 안에 하나도 없었다고 합니다.
둘째, 가장 많이 쓰는 사내 에이전트 플랫폼 한 곳에서만 약 3만 개의 AI Agent가 동시에 연구·엔지니어링 작업을 하고 있습니다.
셋째, 8월 한 달간 이 에이전트들이 내린 결정 10억 건 이상 가운데 0.002%(약 4만 7천 건에 1건)가 실행 전에 차단됐습니다.
(Anthropic은 자사 모델의 역량과 안전성을 함께 좋게 보이게 할 인센티브가 있고, 이 수치는 외부 검증을 거치지 않은 자체 측정입니다. Anthropic도 앞으로 외부 평가 기관을 사내에 두고 이런 지표를 검증받겠다고 밝혔습니다. 비율 자체보다는 이 숫자를 만들어 낸 감시 구조를 보는 편이 좋습니다.)
실행 전 감시와 실행 후 감시
공개 내용 중 가장 참고할 만한 부분은 감시를 두 종류로 나눈 방식입니다.
온라인 모니터는 실행 전에 막는 감시입니다. 모델 가중치를 외부로 복사하는 것처럼 순식간에 일어나고 되돌릴 수 없는 피해를 겨냥합니다. Anthropic은 이렇게 적었습니다.
100% of these agents' actions pass through the online monitor before they are executed, usually within seconds.
오프라인 모니터는 실행이 끝난 뒤에 살피는 감시입니다. 모든 행동 기록을 모아 사후에 읽으면서, 조금씩 쌓이다가 드러나는 이상 징후를 찾습니다. 되돌릴 수 있는 문제를 다루므로 속도보다 범위가 중요합니다.
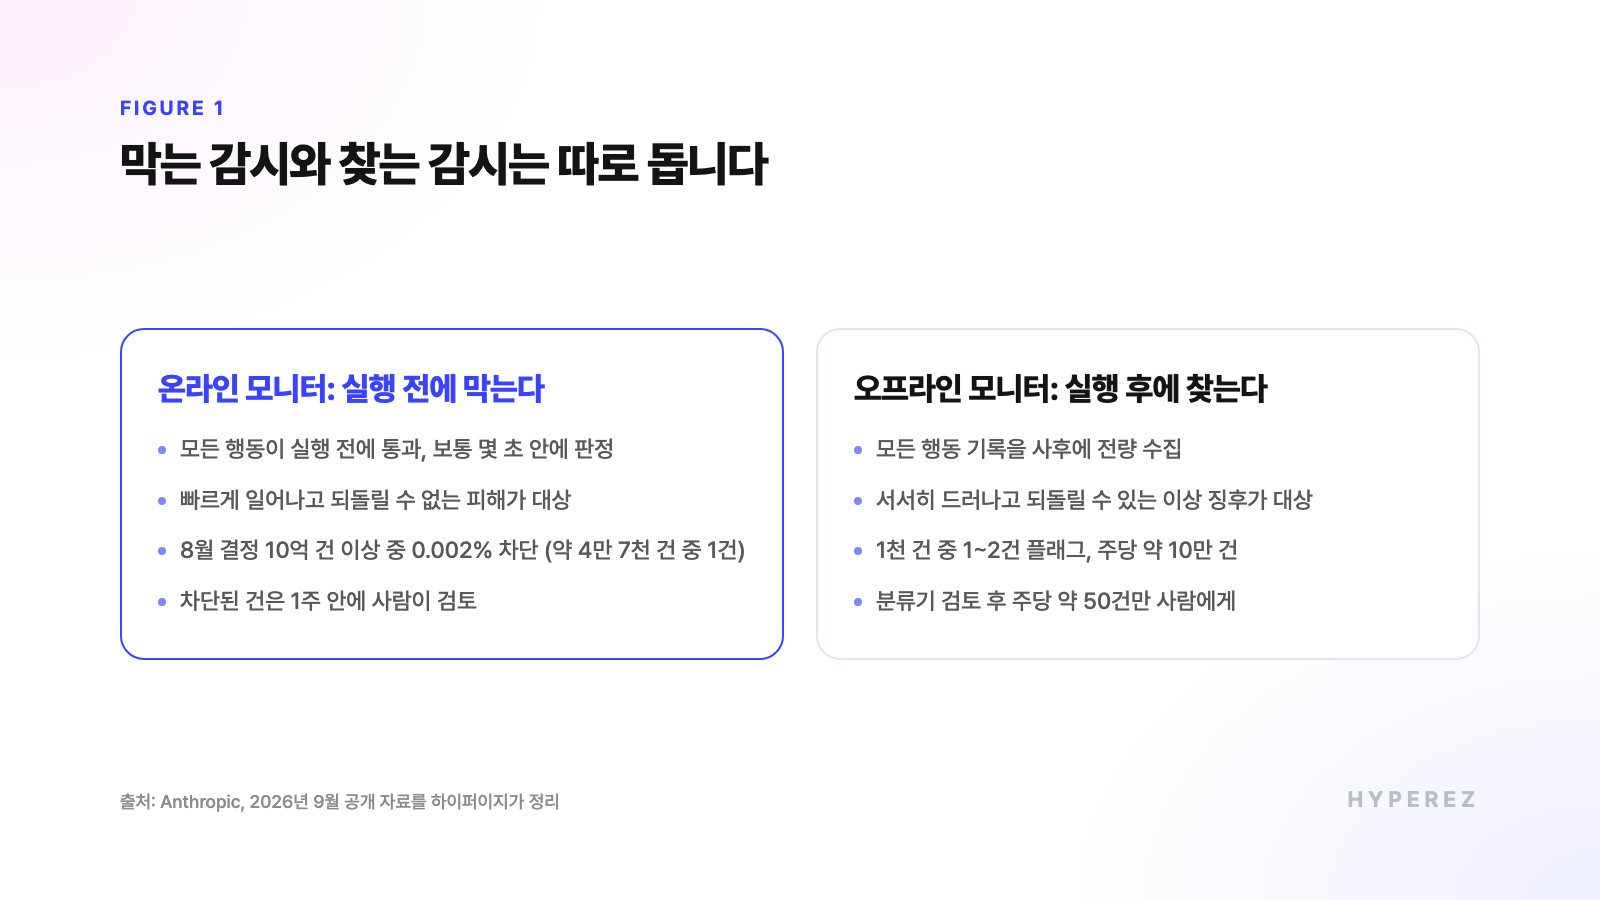
모든 위험을 실행 전에 막으려 하면 에이전트가 멈춰 서고, 전부 사후에 찾으려 하면 되돌릴 수 없는 사고를 놓칩니다. 그래서 되돌릴 수 있는 행동인지를 기준으로 둘을 나눕니다.
기업 환경에 필요한 설계 요소
Anthropic의 구조를 그대로 가져다 쓸 수는 없습니다. 그래도 설계 요소 자체는 기업에서도 똑같이 필요합니다.
커버리지와 예외 경로
Anthropic 수치에서 눈여겨볼 숫자는 100%입니다. 모든 행동이 예외 없이 감시를 거치기 때문에 0.002%라는 차단율도 의미를 갖습니다. 기업에서 흔히 보는 실패는 "급한 작업은 모니터를 건너뛰는" 경로가 생기는 경우입니다. 우회 경로가 하나라도 있으면 나머지 숫자는 전부 참고용 숫자가 됩니다.
되돌릴 수 있는지에 따른 행동 분류
ERP에 전표를 쓰는 일과 초안을 만드는 일은 영향이 다릅니다. 되돌릴 수 없는 행동(외부 발송, 결제, 삭제, 권한 변경)은 실행 전에 검사하고, 되돌릴 수 있는 행동은 사후에 검토합니다. 이 분류표가 먼저 있어야 무엇을 감시할지 정할 수 있습니다.
에이전트별 신원
Anthropic은 에이전트마다 개별 신원을 주고, 에이전트가 만든 데이터를 모두 그 신원으로 기록했다고 설명합니다. 신원을 모델 대신 에이전트 단위로 주기 때문에 모델을 바꿔도 기록이 이어집니다. 에이전트끼리 주고받는 메시지도 공유 채널로만 오가게 해서, 에이전트 사이의 대화까지 감시가 따라갈 수 있게 했습니다. 기업에서 여러 에이전트가 서비스 계정 하나를 같이 쓰면, 사고가 나도 어느 에이전트가 한 일인지 가려낼 방법이 없습니다.
사람이 검토할 양
오프라인 모니터 수치를 차례로 따라가면 구조가 보입니다.
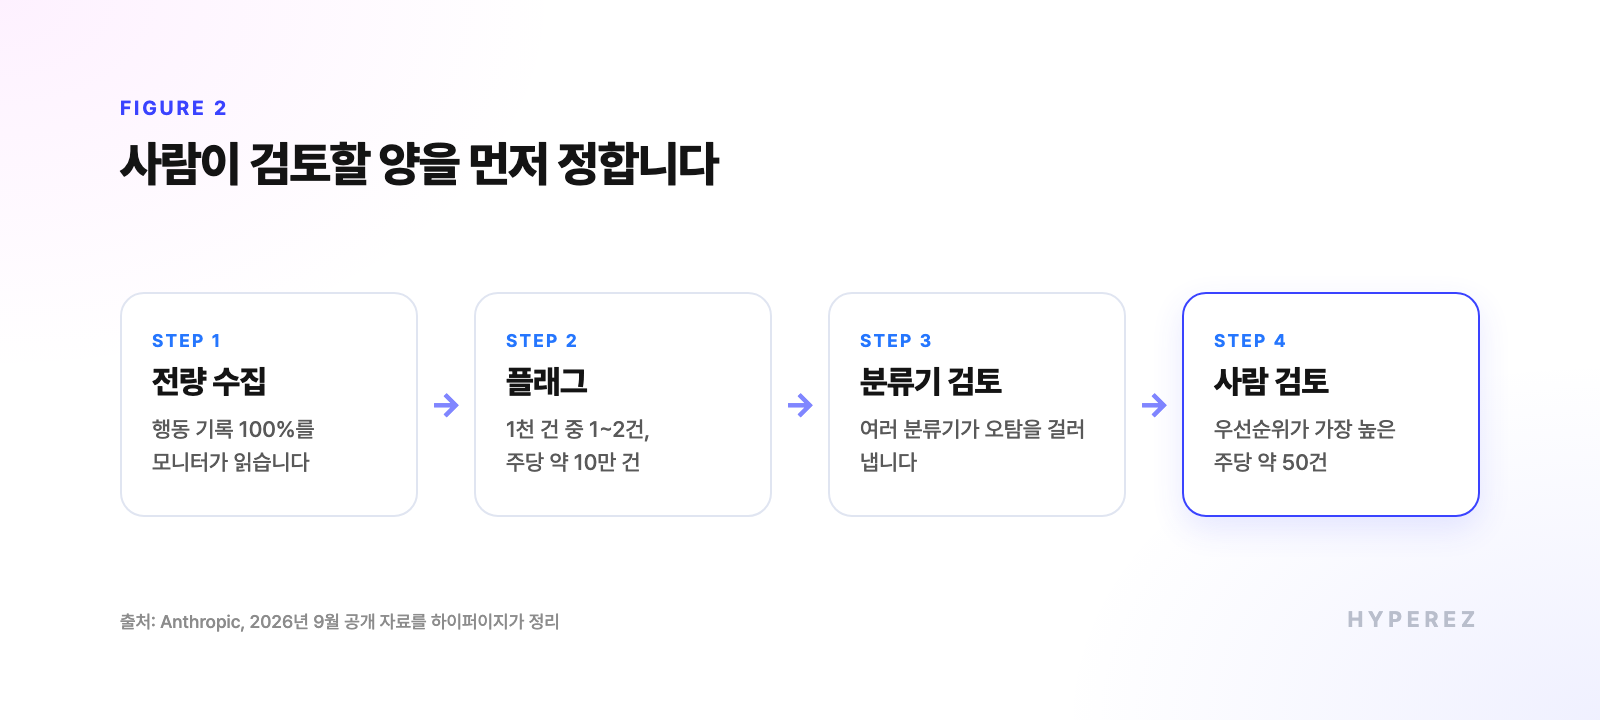
먼저 모든 행동을 수집하고, 1천 건 중 1~2건꼴로 플래그를 붙입니다. 이렇게 주당 약 10만 건이 쌓이면 여러 분류기가 오탐을 걸러 내고, 최종적으로 사람이 보는 건 주당 50건 정도입니다. 실행 전에 차단된 건은 1주 안에 사람이 검토합니다. 사람의 검토 시간이 가장 비싼 자원이다 보니, 사람 손에 넘어가는 양을 처음부터 숫자로 정해 둔 셈입니다.
실전에서 자주 생기는 문제
낮은 차단율이 뜻하는 것
차단이 적다는 건 에이전트가 잘 행동한다는 뜻일 수도 있고, 모니터가 못 잡고 있다는 뜻일 수도 있습니다. Anthropic도 이 점을 스스로 한계로 적었습니다.
At this scale of agent activity, it is hard to be certain we have a complete picture of all possible kinds of behaviors.
그래서 Anthropic은 외부 기관 METR에 오프라인 모니터링 플랫폼의 레드팀 점검을 맡긴 적이 있다고 밝혔습니다. 알려진 오작동을 일부러 넣어 보고 모니터가 잡아내는지 확인하지 않으면, 차단율은 해석할 수 없는 숫자로 남습니다.
감시 모델의 사각지대
모델로 에이전트를 감시하면, 감시하는 모델이 감시받는 쪽과 같은 종류의 오류를 낼 수 있습니다. Anthropic은 사내 자동화 비율을 매길 때도 이 문제를 짚으며, 다른 개발사의 모델이나 제3자로 교차 검증하는 방안을 내놓았습니다. 기업에서도 에이전트가 쓰는 모델과 감시하는 모델이 같은지 한 번쯤 따져 볼 필요가 있습니다.
"성공"으로 기록된 실패
가장 잡기 어려운 건 에러 없이 끝나는 실패입니다. 작업은 정상 종료로 기록됐는데 산출물이 없거나, 도중에 끊긴 채 끝난 경우입니다. 실행 상태만 보는 감시로는 이런 건을 놓칩니다. 이런 실패까지 잡으려면 감시 기준을 "에이전트가 끝났다고 말했는가"에서 "기대한 결과물이 실제로 있는가"로 옮겨야 합니다.
하이퍼이지의 접근
어떤 행동이 되돌릴 수 없는지, 어떤 데이터가 민감한지는 기업마다 다릅니다. 이 기준을 매번 사람이 판단하면 에이전트가 늘어날수록 버티기 어렵습니다. 하이퍼이지의 Skein OS는 기업의 업무 규칙을 온톨로지로 정의해 두고, 그 위에서 24시간 돌아가는 이상 감지와 자동 워크플로우를 운영합니다. 막을 기준이 먼저 정의돼 있어야 감시도 숫자로 관리할 수 있습니다.
정리
Anthropic 발표에서 눈여겨볼 부분은 26%나 3만 개라는 숫자보다 그 뒤의 구조입니다. 모든 행동이 감시를 거치고, 되돌릴 수 없는 행동은 실행 전에 막고, 나머지는 사후에 전부 읽고, 사람에게는 감당할 수 있는 양만 넘깁니다. 에이전트가 늘어날수록 이 구조를 먼저 갖췄는지가 도입 속도를 좌우합니다.