

망분리 AI 도입: GPU와 클라우드 없이 기관 안에서 시작하는 방법
"생성형 AI를 업무에 써 보라"는 지시가 내려와도 망분리 기관의 담당자가 당장 할 수 있는 일은 많지 않습니다. 업무망 PC에서는 외부 AI 서비스에 접속할 수 없고, 클라우드는 규정상 쓸 수 없습니다. GPU 서버를 들이자니 예산 심의에서 막힙니다. 결국 인터넷망 PC에서 개인적으로 써 보다가, 업무 자료를 옮길 수 없어 거기서 멈춥니다.
이런 조건에서 AI 도입을 시작한 사례가 최근 국내외에서 잇따라 나왔습니다. 이 사례들은 외부 모델을 빌려 쓰는 대신, 기관 안에서 운영할 수 있는 모델 규모와 운영 위치를 먼저 정했습니다.
망분리가 완화돼도 기관 안에서 운영해야 하는 이유
규제는 조금씩 풀리고 있습니다. 금융위원회는 2024년 8월 13일 「금융분야 망분리 개선 로드맵」을 발표하고, 샌드박스를 통해 금융권의 생성형 AI 활용을 허용하기로 했습니다. 금융권에 망분리가 도입된 지 약 10년 만의 변화였습니다. 공공 부문에서는 국가정보원이 2025년 9월 9일 국가 망 보안체계(N2SF) 보안가이드라인 정식판을 공개했습니다. 모든 전산망을 똑같이 끊는 대신 기밀(C), 민감(S), 공개(O) 세 등급으로 나누고 등급마다 보안 수준을 달리 적용하는 방식입니다.
그렇다고 외부 AI 서비스를 마음대로 쓸 수 있게 된 것은 아닙니다. 금융권 샌드박스는 보안대책을 조건으로 걸고, 금융감독원과 금융보안원이 신청 기업마다 보안 점검을 합니다. N2SF에서도 기밀 등급 업무는 여전히 분리된 채로 남습니다. 민감한 데이터를 다루는 업무일수록 AI도 기관 안에서 운영해야 한다는 점은 그대로입니다.
폐쇄망 AI 도입 단계
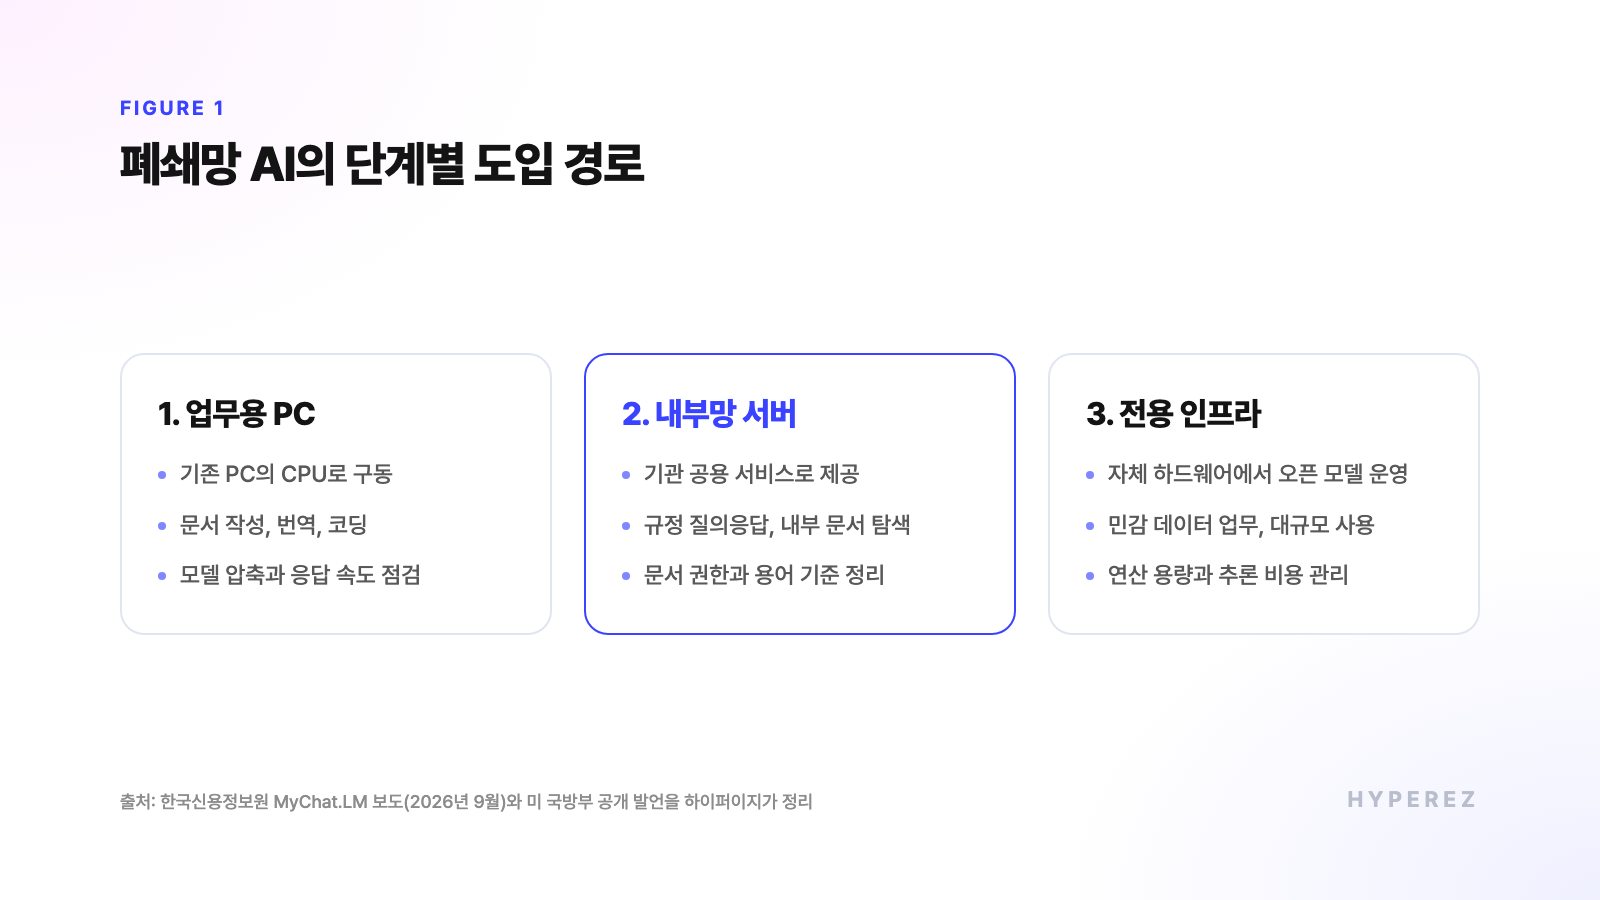
최근 사례를 모아 보면 도입은 업무용 PC 한 대에서 시작해 내부망 서버로 확대하고, 규모가 커지면 전용 인프라를 직접 운영하는 순서로 이어집니다.
업무용 PC: 한국신용정보원 MyChat.LM
한국신용정보원은 외부 연결 없이 업무용 PC에서 실행되는 로컬 AI 엔진 MyChat.LM을 개발해 2026년 9월부터 내부망과 보안망에 정식 배포하고 있습니다(바이라인네트워크, 2026년 9월 23일). GPU 없이 CPU만으로 실행되도록 모델 파일을 압축하고, KV 캐시 압축 수준과 재사용 방식을 조정했습니다. CPU 코어별 처리 속도를 재서 사용자마다 자원을 나눠 주는 방식도 넣었습니다. 쓰임새는 문서 작성, 번역, 코딩, 규정 질의응답, 내부 문서 탐색입니다.
한국신용정보원은 업무망에서 AI를 자유롭게 쓰지 못하는 금융권의 한계 때문에 개발을 시작했다고 밝혔습니다. PC와 내부망 환경에서 외부 연결 없이 AI를 실행할 수 있는지를 고민한 결과라는 설명입니다. (모델 크기나 성능 수치는 공개되지 않았고, 모두 기관이 직접 밝힌 내용입니다.)
내부망 서버: 기관 공용 서비스로 확대하기
PC 한 대에서 실행하는 모델은 한 사람의 작업을 돕는 데 맞춰져 있고, 성능도 그 PC의 사양을 넘지 못합니다. 여러 부서가 같은 규정과 문서를 두고 묻고 답하게 하려면 모델을 내부망 서버로 옮겨 기관 공용 서비스로 제공해야 합니다. MyChat.LM도 다음 계획으로 CPU나 저사양 GPU 서버에서 쓸 수 있는 LLM API를 내놓고, 이어서 특정 금융 업무를 자동화하는 에이전트까지 만들겠다고 밝혔습니다. 단말에서 시작해 내부망 서비스로, 다시 업무 자동화로 넘어가는 순서가 한 기관의 계획 안에 그대로 들어 있습니다.
이 단계부터는 모델보다 데이터가 어렵습니다. 여러 부서의 문서가 한곳에 모이면 누가 어떤 문서를 볼 수 있는지, 부서마다 다르게 쓰는 용어를 어떻게 맞출지를 먼저 정해야 합니다.
전용 인프라: 오픈 모델을 직접 운영하기
다루는 데이터가 민감할수록 오픈 모델을 자체 하드웨어에서 운영하려는 경향이 강해집니다. 2026년 9월 23일 Hacker News의 오픈 모델 토론에서 한 개발자(Zaraif13)는 대기업의 공급망 업무를 자동화하는 에이전트를 이틀간 만들며 느낀 점을 적었습니다.
Those seemingly boring workflows had bank statements, supplier IDs and other sensitive information.
그는 이런 데이터를 폐쇄형 모델에 넘길 수는 없다고 판단했습니다. 같은 토론에는 사내 하드웨어에서 오픈 모델을 운영하는 방안을 검토하고 있다는 댓글도 이어졌습니다.
전용 인프라 단계에서 남는 과제는 비용입니다. 미 국방부의 생성형 AI 플랫폼 GenAI.mil이 참고가 됩니다. 폐쇄망 사례는 아니지만 규모가 커질 때 무엇이 병목이 되는지 보여 줍니다. 국방부는 전체 300만 명 가운데 170만 명이 GenAI.mil을 써 봤고, 그중 약 50만 명이 매일 쓴다고 밝혔습니다(DefenseScoop, 2026년 9월 23일). 앞으로 기밀망(SIPR)과 극비망(JWICS)까지 확대할 계획입니다. 국방부 최고디지털AI책임자(CDAO) Cameron Stanley는 과제로 연산 용량과 추론 비용을 들었습니다.
models that we have are fit for purpose, that they are the right size and scope and shape for what we're using them for, so we can reduce the inference side and the inference cost.
(국방부는 도입 성과를 크게 보이게 할 이유가 있는 발표 주체입니다. 사용자 수보다는 비용과 용량을 과제로 든 대목이 더 참고할 만합니다.)
실전에서 자주 생기는 문제
모델 크기부터 고르는 경우
어떤 모델을 쓸지부터 정하면 사양 비교만 하다 끝나기 쉽습니다. MyChat.LM은 평가 기준을 두 갈래로 나눴습니다. 하나는 업무 품질(한국어 질의응답, 문서 작성·요약, 정보 추출, 코드·SQL 생성)이고, 다른 하나는 실행 효율(응답 시작 시간, 토큰 생성 속도, 메모리 사용량, 긴 문맥 처리)입니다. 기관 PC에서 실제로 쓸 만한지는 두 번째 목록으로 판단합니다. 답이 좋아도 첫 글자가 나오기까지 한참 걸리면 현장에서는 손이 가지 않습니다.
보안 검증 기간을 일정에 넣지 않은 경우
MyChat.LM은 6월까지 안정화, 부하 테스트, IT 보안 검증을 거쳤고, 7~8월에 보안성과 사용자 피드백을 다시 점검한 뒤 9월에 정식 배포를 시작했습니다. 검증에만 몇 달이 들어간 셈입니다. 망분리 기관이라면 이 구간을 처음부터 일정에 넣어 두는 편이 안전합니다. 개발이 끝났다고 곧바로 배포할 수 있는 환경이 아닙니다.
업무용 PC 단계에서 멈추는 경우
PC 안의 AI는 빨리 들일 수 있지만 한 사람의 작업 단위에 머물기 쉽습니다. 규정 질의응답이 쓸모 있으려면 모두가 같은 최신 규정을 기준으로 답을 받아야 하고, 부서를 넘나드는 업무를 도우려면 여러 부서의 데이터가 한곳에서 연결돼야 합니다. 첫 단계는 AI를 쓰는 문턱을 낮추는 데 의미가 있습니다. 기관 전체의 효율은 두 번째 단계에서 데이터를 어떻게 연결하느냐에 달려 있습니다.
하이퍼이지가 폐쇄망에서 일하는 방식
하이퍼이지의 온톨로지 기반 AI 운영체계는 제조·물류·화학 등 보안에 민감한 폐쇄망 6개 현장에서 3년 넘게 운영되고 있습니다. 공군 항공기 정비 AI 운영체계(AX-MRO) 과제도 같은 엔진을 씁니다. 새 플랫폼을 만드는 대신 코어 엔진은 그대로 두고, 정비 도메인의 온톨로지와 군 폐쇄망 요건만 따로 구축합니다. 시스템은 외부 네트워크 연결 없이 군 폐쇄망 안에서 운영됩니다. 과제 내용은 공군 과제 소개 글에 정리해 두었습니다.
앞의 단계로 보면 하이퍼이지는 주로 두 번째인 내부망 서버 단계를 맡습니다. 흩어진 기관 데이터가 하나의 기준으로 정리돼 있어야 모델이 기관 전체의 일을 도울 수 있습니다. Skein OS는 온프레미스와 하이브리드 배포를 모두 지원하고, 민감 데이터를 외부로 내보내지 않는 구조로 설계됐습니다.
정리
GPU와 클라우드가 없다는 조건은 출발을 늦출 뿐, 도입을 막지는 못합니다. 업무용 PC에서 먼저 쓰게 하고, 내부망에서 데이터를 연결하고, 규모가 커지면 업무에 맞는 크기의 모델을 직접 운영하면 됩니다. 어느 단계에서든 모델을 어디서 운영할지, 모델이 어떤 데이터를 쓸지를 먼저 정해야 합니다.