

LLM만으론 기업이 안 돌아간다: Ground Truth와 온톨로지
AI 도입률은 역대 최고인데, 실제 성과를 내는 기업은 5%에 불과하다고 합니다. 모델이 부족해서가 아닙니다. 기업 안에 'AI가 참고할 사실'이 정리되어 있지 않아서입니다.
기업 AI의 진짜 장벽, Ground Truth의 부재
LLM은 학습된 '세계의 평균'을 말합니다. 우리 회사의 계약 조건이나 생산 라인의 허용 오차, 고객사별 SLA 같은 기업 고유의 진실은 모릅니다. 같은 질문에도 오늘의 답과 내일의 답이 달라지는 이유입니다.
기업에는 누가 물어도 같은 답이 나와야 하는 영역이 있습니다. "이 주문은 지금 어떤 상태인가", "이 자재는 어느 공정에서 소진되는가", "이 고객에게 적용될 할인율은 얼마인가". 저희는 이걸 Ground Truth라고 부릅니다. 재무팀 Excel, CRM 티켓, ERP 전표, 현장 엔지니어의 머릿속. 기업 곳곳에 흩어져 있고 시스템마다 언어가 다릅니다.
LLM에 RAG로 문서를 붙인다고 풀리는 문제가 아닙니다. 문서 조각을 그럴듯하게 조립할 뿐, "이 숫자가 맞다"를 증명하지는 못합니다.
온톨로지가 하는 일
온톨로지는 기업의 개념들(주문·자재·고객·공정)과 그 사이의 관계를 구조로 정의하는 방법입니다. 단순한 용어집이 아니라, 추론 가능한 그래프입니다.
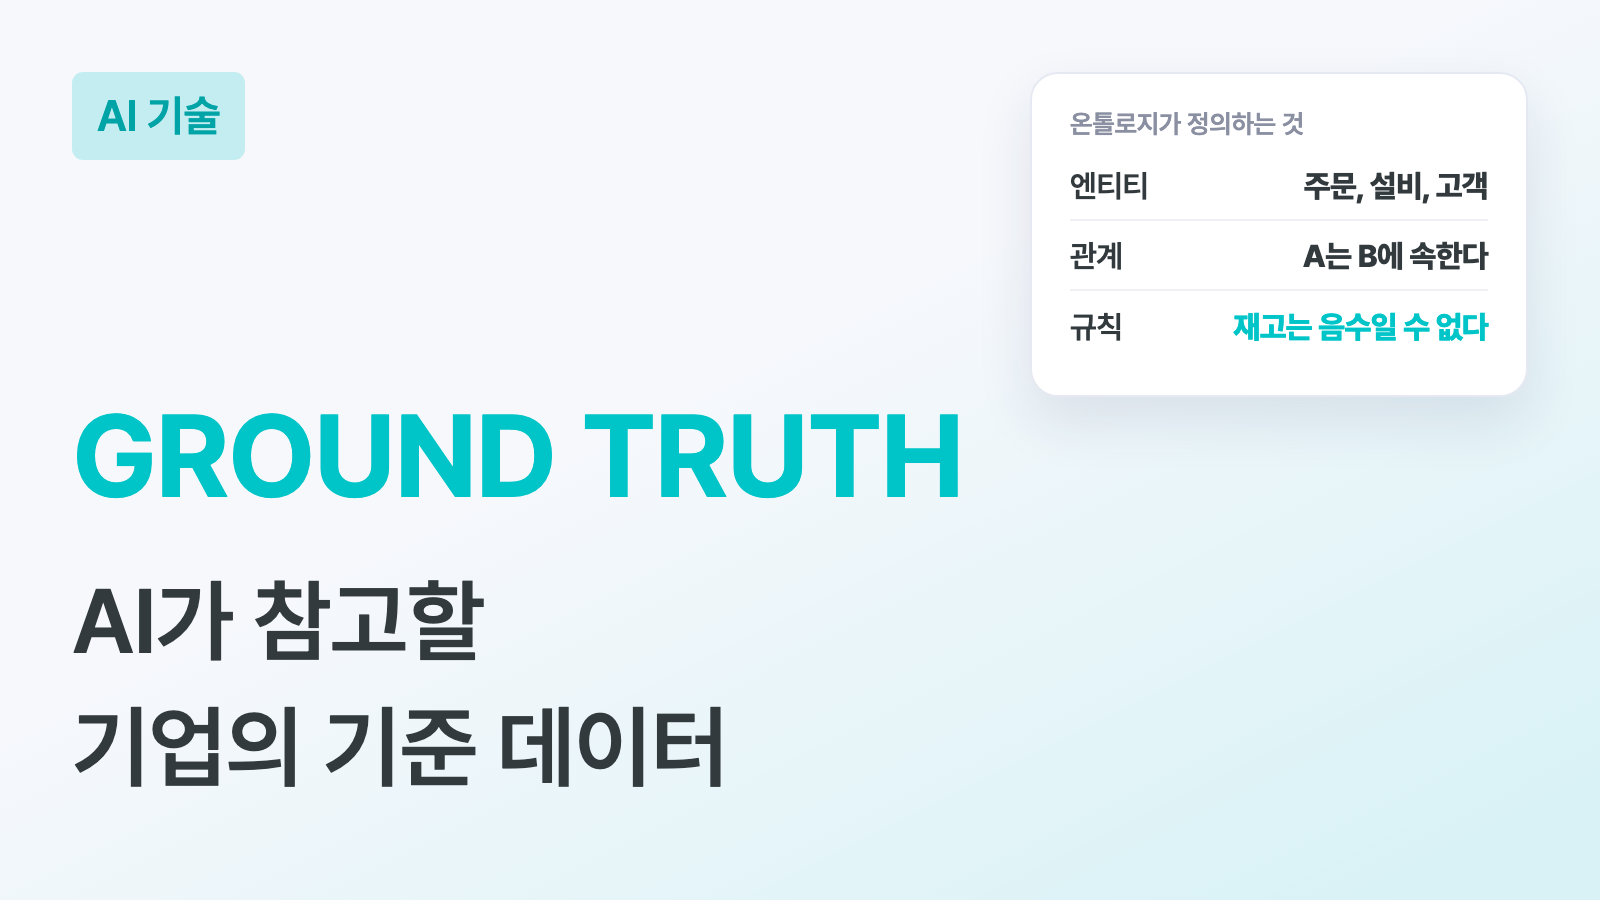
- 엔티티(Entity): 비즈니스의 기본 단위. 주문, 설비, 계약, 고객 같은 것들입니다.
- 관계(Relation): 엔티티 사이의 연결. "A는 B에 속한다", "C는 D에서 파생된다" 처럼 표현됩니다.
- 규칙(Axiom): 반드시 성립해야 하는 제약. "재고는 음수일 수 없다", "미결제 주문은 출고될 수 없다" 같은 것입니다.
이렇게 정의된 구조 위에서 AI는 자연어로 추측하는 대신 수리논리로 계산합니다. "이 주문이 지금 출고 가능한가?"라는 질문은 문서 검색이 아니라 그래프 탐색 문제가 됩니다. 답이 재현 가능해지고, 근거가 되는 경로를 그대로 보여줄 수 있습니다.
LLM과 온톨로지, 역할 분담이 핵심
둘은 경쟁 관계가 아닙니다. 층이 다릅니다.
- LLM은 사용자의 자연어 의도를 해석하고, 결과를 자연어로 풀어내는 인터페이스 레이어입니다.
- 온톨로지는 사실과 규칙을 담는 지식 레이어입니다. 답의 근거가 여기에 있습니다.
사용자가 "지난달 대비 출고 리드타임이 늘어난 라인은?"이라고 물으면, LLM이 이 문장을 쿼리로 변환하고, 온톨로지 위에서 실제 계산이 일어나고, LLM이 다시 결과를 사람 말로 설명합니다. 매번 같은 숫자, 같은 근거, 같은 답입니다.
이 구조의 부수 효과도 큽니다. LLM이 모든 맥락을 토큰으로 실어나를 필요가 없어지면서, 토큰 비용이 LLM 단독 의존 대비 90% 이상 줄어듭니다. 답의 품질은 올라가는데 비용은 내려가는, 흔치 않은 트레이드오프입니다.
실전에서 온톨로지가 어려운 이유
이론은 오래됐습니다. 하지만 기업에 온톨로지를 이식하는 일은 여전히 어렵습니다. 세 가지 장벽이 있습니다.
- 도메인 지식이 문서화되어 있지 않습니다. 베테랑 엔지니어의 머릿속에만 있는 규칙이 적지 않습니다.
- 시스템마다 같은 개념을 다르게 부릅니다. '고객'이 CRM, ERP, 현장 Excel에서 각각 다른 ID로 삽니다.
- 규칙이 계속 바뀝니다. 온톨로지는 살아있어야 합니다. 문서화 후 방치되면 금세 무용지물이 됩니다.
저희가 Skein OS를 만들면서 '지식 사전(Knowledge Dictionary)'이라는 레이어를 별도로 둔 이유입니다. 현장의 용어와 온톨로지 엔티티를 매핑하고, 규칙 변경 이력을 자동 추적합니다. 기술보다 운영이 핵심인 영역이라는 걸 현장에서 반복해 확인했기 때문입니다.
정리하며
AI가 실제 비즈니스에서 작동하려면, 모델이 아니라 사실이 먼저 정리되어야 합니다. 온톨로지는 기업의 사실을 AI가 추론 가능한 형태로 저장하는 방법이고, LLM은 그 위에서 사람과 소통하는 창구입니다.
LLM이 똑똑해질수록 Ground Truth의 중요도는 오히려 커집니다. 기업 AI의 다음 단계는 더 큰 모델이 아니라, 더 잘 정리된 기업의 진실입니다.
관련 글
Palantir 3분기 실적으로 본 온톨로지, 한국 기업에는 무엇이 먼저일까
Palantir의 2026년 3분기 실적에서 미국 상업 매출이 회사 역사상 처음으로 미국 정부 매출을 넘었습니다. 이 숫자에서 읽을 수 있는 것과 한계를 짚고, 온톨로지가 국방에서 기업 현장으로 넓어질 때 하이퍼이지가 도구보다 먼저 정하는 기준을 정리합니다.
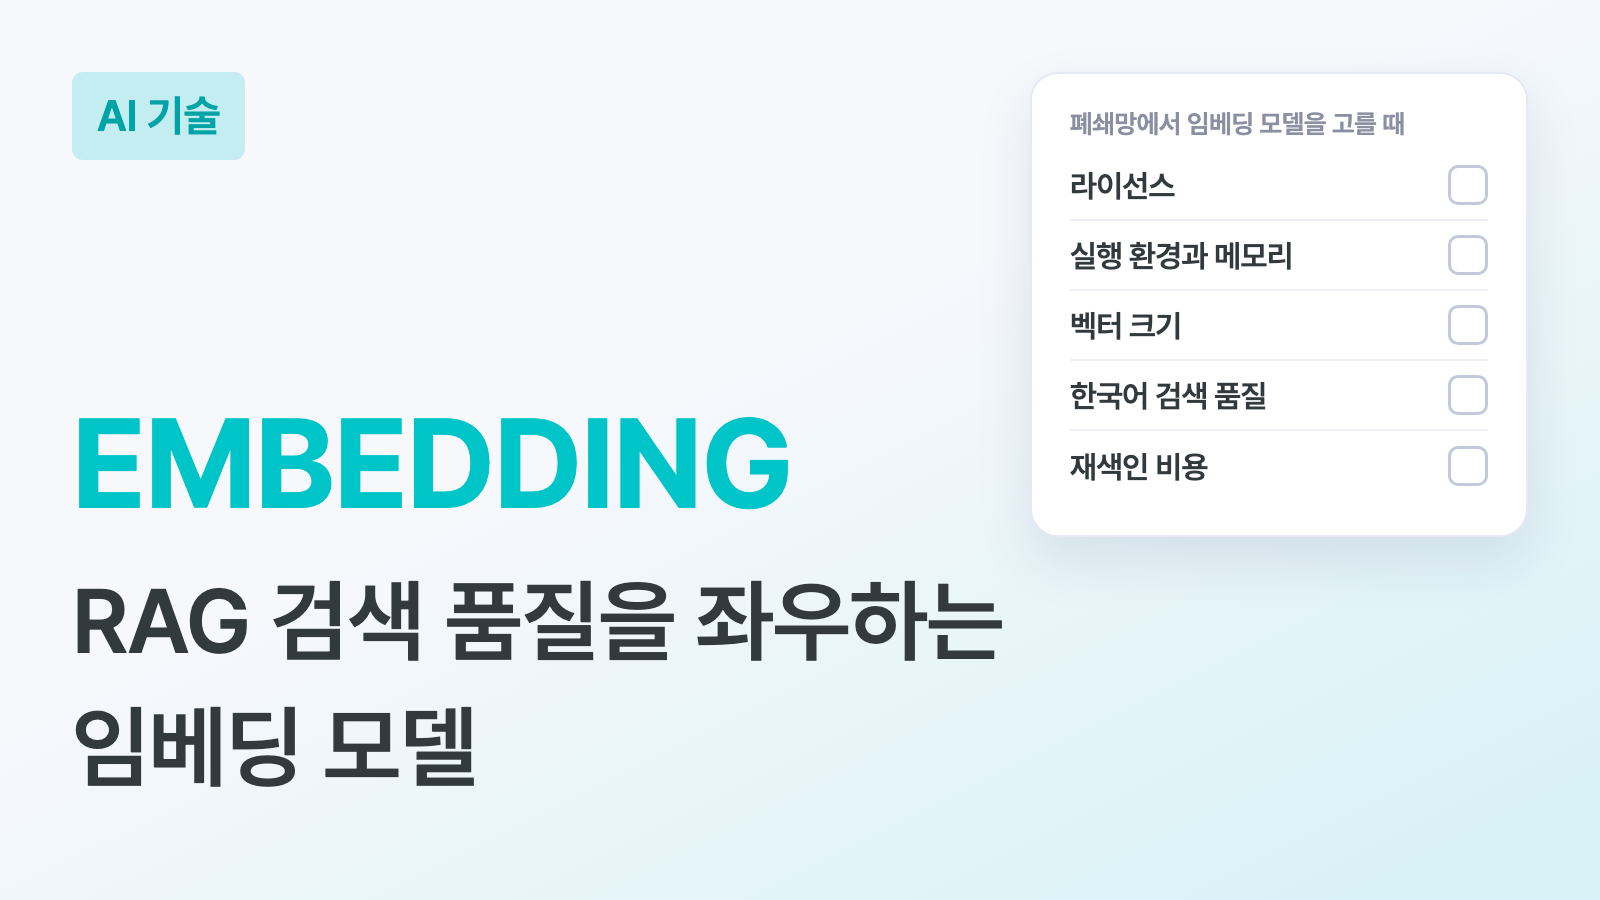
임베딩 모델 뜻: RAG 검색 품질을 좌우하는 부품과 폐쇄망에서 고르는 기준
임베딩 모델은 문장과 문서를 벡터로 바꿔 뜻이 비슷한 글끼리 가까운 위치에 놓는 AI 모델이고, RAG에서는 답변 모델에 넘길 문서를 고르는 단계를 맡습니다. 임베딩의 뜻과 RAG 안에서 하는 일을 정리하고, 외부 API를 쓸 수 없는 폐쇄망 기관이 임베딩 모델을 고를 때 확인할 기준을 살펴봅니다.
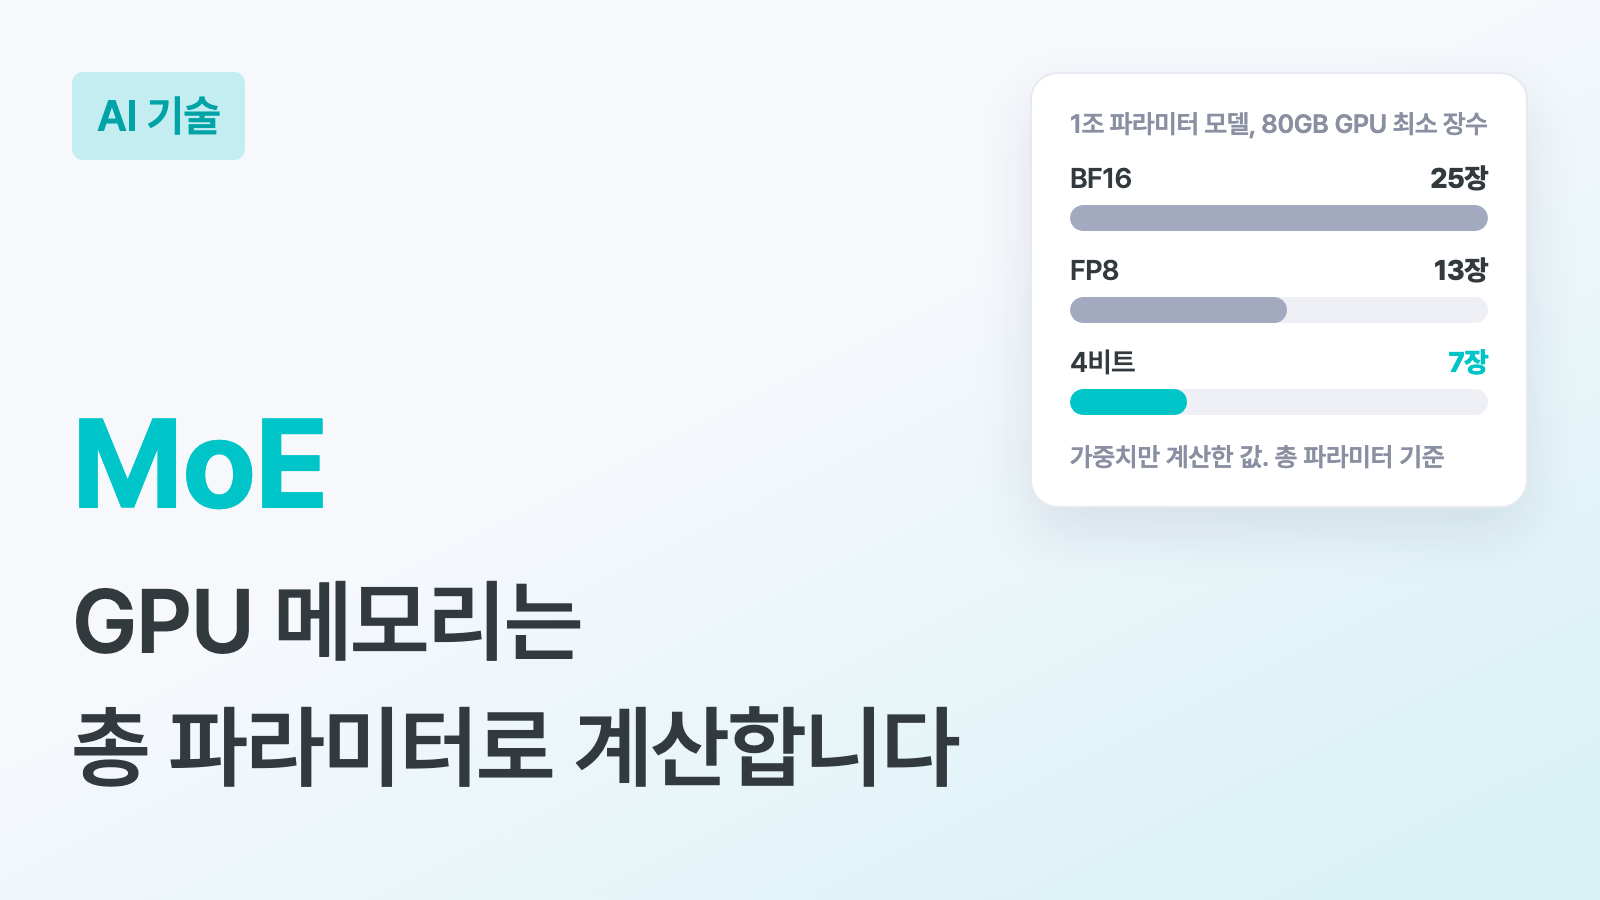
MoE 뜻: 총 파라미터와 활성 파라미터, 온프렘 GPU 산정 기준
MoE는 모델 안에 여러 전문가 신경망을 두고 토큰마다 일부만 골라 계산하는 구조입니다. 계산량은 활성 파라미터를 따르지만, GPU 메모리에는 전체 가중치를 올려야 합니다. 총 1조 파라미터 중 490억 개만 활성화하는 Mistral Large 4를 예로, 온프렘 GPU를 산정할 때 따로 계산해야 할 것을 정리합니다.