

MoE 뜻: 총 파라미터와 활성 파라미터, 온프렘 GPU 산정 기준
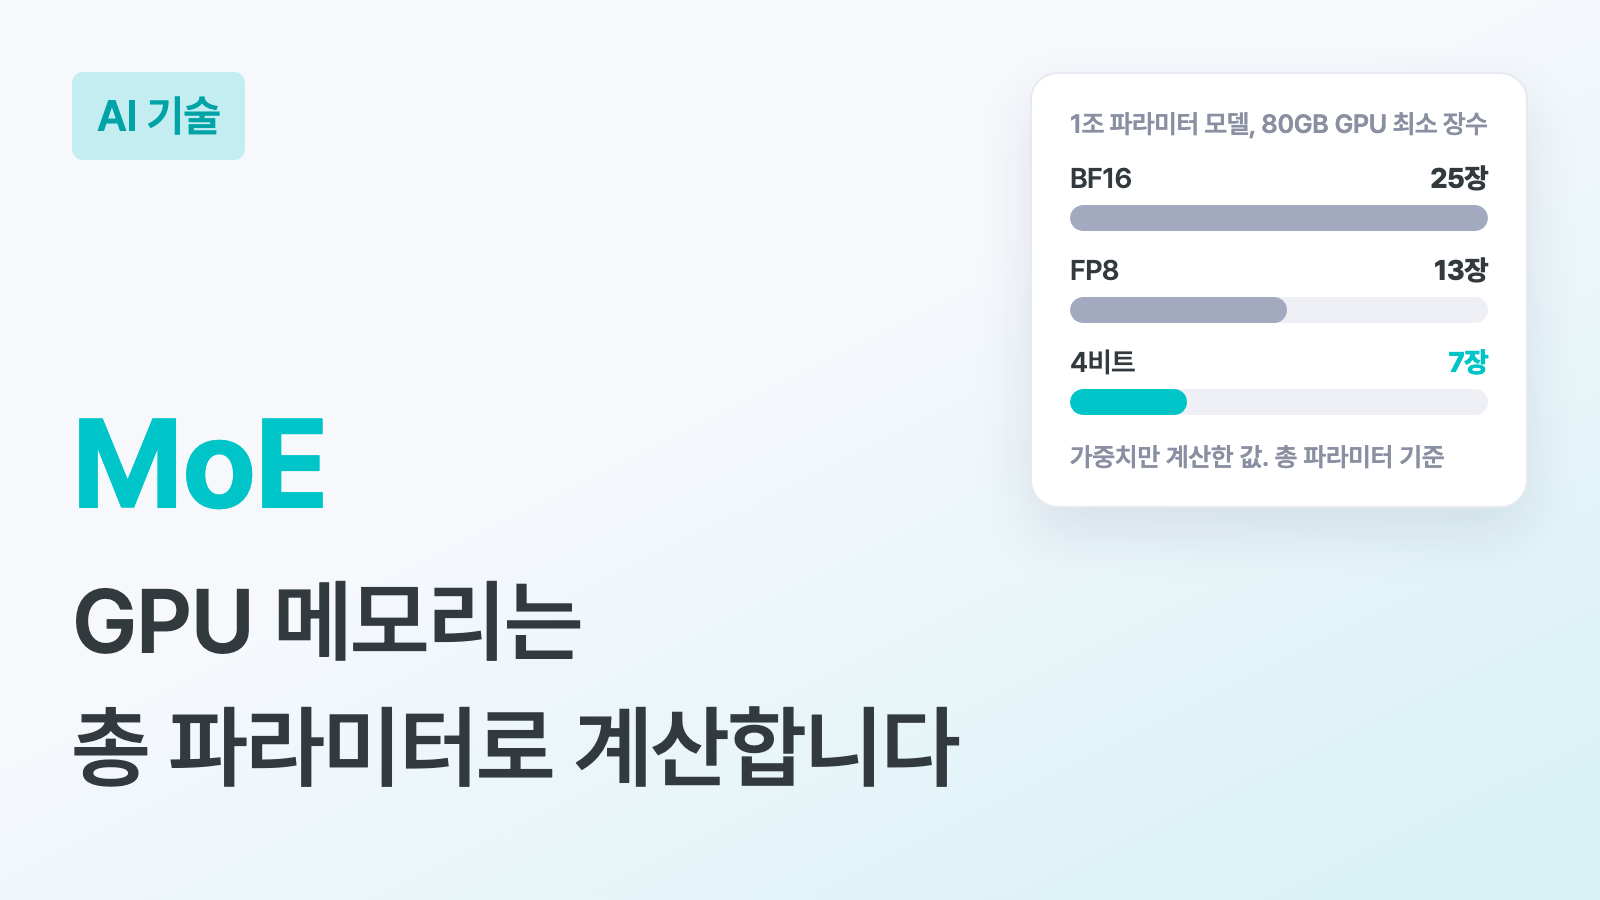
총 1조 파라미터 모델인데 토큰 하나를 처리할 때는 490억 개만 쓴다는 설명을 들으면, 서버도 490억 기준으로 준비하면 될 것처럼 보입니다. 490억 파라미터 모델이라면 GPU 몇 장으로 충분하니 폐쇄망 안에 들여 놓는 데 큰 부담이 없겠다는 계산인데, 막상 견적을 받아 보면 필요한 GPU가 예상보다 몇 배 많습니다. 두 숫자가 각각 무엇을 정하는지 구분하지 않았기 때문입니다.
MoE(Mixture of Experts, 전문가 혼합)는 모델 안에 여러 개의 전문가 신경망을 두고, 토큰마다 라우터가 그중 일부만 골라 계산하게 하는 모델 구조입니다. 모델이 가진 전체 파라미터 수를 총 파라미터, 토큰 하나를 처리할 때 실제 계산에 쓰는 파라미터 수를 활성 파라미터라고 부릅니다. Mistral AI가 2026년 10월 6일 공개한 Mistral Large 4는 총 파라미터가 1조 개, 활성 파라미터가 490억 개입니다.
MoE 뜻: 전문가와 라우터의 구조
일반적인 언어 모델(밀집 모델, dense model)은 토큰 하나를 처리할 때 모든 파라미터를 계산에 씁니다. MoE 모델은 층마다 일부를 여러 전문가로 나눠 두고, 라우터가 토큰마다 어느 전문가에게 보낼지 정합니다. 라우터가 고르지 않은 전문가는 그 토큰을 계산하지 않습니다.
Mistral AI가 2024년 1월 공개한 Mixtral 8x7B 논문을 보면 구조가 잘 보입니다. 각 층에 전문가 8개를 두고, 라우터가 토큰마다 2개를 골라 결과를 합칩니다. 그래서 토큰 하나가 접근할 수 있는 파라미터는 470억 개인데, 실제 계산에 쓰는 것은 130억 개라고 합니다. 이름은 8x7B인데 총 파라미터가 560억 개보다 적은 것은, 전문가로 나뉘는 부분이 피드포워드 층뿐이고 나머지 층은 전문가들이 같이 쓰기 때문입니다.
Hugging Face가 2023년 12월 정리한 MoE 해설은 이 구조의 비용을 한 문장으로 짚습니다.
However, all parameters need to be loaded in RAM, so memory requirements are high.
어떤 토큰이 어느 전문가로 갈지 미리 알 수 없으니, 계산은 일부만 해도 전문가 전체를 메모리에 올려 둬야 합니다.
왜 지금 MoE를 다시 볼까요?
MoE는 새로 나온 개념은 아닙니다. 다만 가중치를 내려받아 기관 안에서 운영할 수 있는 대형 모델이 MoE로 나오다 보니, 온프렘 도입을 검토하는 곳에서도 이 구분이 필요해졌습니다.
Mistral Large 4는 지금 API 미리보기로 제공되고, 가중치는 10월 말(보도 기준 10월 27일)에 공개할 예정입니다. 라이선스 조건은 아직 자세히 나오지 않았습니다. 독일 알레프 알파가 공개한 콜리브리도 총 781억 개 중 토큰당 34억6000만 개(약 4.4%)만 활성화하는 MoE 모델이고, 아파치 2.0 라이선스로 가중치를 공개했다고 합니다. 두 회사 모두 외부 클라우드에 의존하지 않는 온프레미스 구축을 내세웁니다.
| 모델 | 총 파라미터 | 활성 파라미터 | 활성 비율 | 가중치 공개 |
|---|---|---|---|---|
| Mixtral 8x7B | 470억 | 130억 | 약 28% | 공개 |
| 콜리브리 | 781억 | 34억6000만 | 약 4.4% | 공개 (아파치 2.0) |
| Mistral Large 4 | 1조 | 490억 | 약 4.9% | 10월 말 예정, 라이선스 미정 |
활성 비율이 낮을수록 토큰마다 드는 계산은 가벼워지는데, 메모리에 올려야 하는 양은 총 파라미터 그대로입니다.
온프렘 GPU 산정에 들어가는 요소
메모리: 총 파라미터 기준
GPU 메모리에는 모든 전문가의 가중치를 올려야 하므로 총 파라미터 수로 계산합니다. Mistral Large 4라면 1조 개가 기준입니다. 활성 파라미터 490억 개로 계산하면 필요한 메모리를 20분의 1 수준으로 적게 잡게 됩니다.
계산량: 활성 파라미터 기준
토큰 하나를 만들 때 드는 연산은 활성 파라미터를 따릅니다. Hugging Face 해설은 Mixtral이 토큰마다 전문가 2개를 쓸 때 연산량이 120억 파라미터 모델과 비슷하다고 설명합니다. 총 파라미터가 같은 밀집 모델보다 답이 빨리 나오는 이유입니다.
정밀도: 양자화에 따라 달라지는 메모리
파라미터 하나를 몇 바이트로 저장하느냐에 따라 같은 모델도 메모리 크기가 달라집니다. BF16은 2바이트, FP8은 1바이트, 4비트 양자화는 0.5바이트입니다. 많이 줄일수록 메모리는 적게 들지만 답의 품질이 떨어지는 경우가 있어서, 업무 데이터로 시험해 본 뒤 어느 정밀도로 운영할지 결정합니다. Mistral Large 4가 어떤 정밀도로 가중치를 배포할지는 아직 나오지 않았습니다.
동시 사용자와 문맥 길이
가중치 말고도 대화 문맥을 담아 두는 KV 캐시가 GPU 메모리를 씁니다. 동시 사용자가 많고 한 번에 넣는 문서가 길수록 KV 캐시도 커집니다. 가중치만으로 GPU 메모리를 거의 채우면, 운영 단계에서 동시에 처리할 수 있는 요청 수가 크게 줄어듭니다.
1조 파라미터 모델의 GPU 메모리 추정
아래는 가중치만 계산한 추정치입니다. 총 파라미터 1조 개에 정밀도별 바이트 수를 곱했고, GPU 장수는 메모리 80GB짜리 GPU를 예로 들어 단순히 나눈 값입니다. KV 캐시, 실행 여유분, GPU 사이 통신은 넣지 않았으니 실제로는 이보다 더 필요합니다.
| 정밀도 | 파라미터당 크기 | 가중치 메모리 (추정) | 80GB GPU 기준 최소 장수 (가중치만) |
|---|---|---|---|
| BF16 | 2바이트 | 약 2,000GB | 25장 |
| FP8 | 1바이트 | 약 1,000GB | 13장 |
| 4비트 | 0.5바이트 | 약 500GB | 7장 |
같은 계산을 활성 파라미터 490억 개로 하면 BF16에서도 약 98GB여서, 80GB GPU 2장이면 될 것처럼 보입니다. 이 글 처음에 든 계산 착오가 여기서 생깁니다. 4비트로 줄여도 80GB GPU 8장을 넣은 서버 한 대(640GB)에 가중치를 담고 나면 남는 메모리는 140GB 정도이고, 이 안에서 KV 캐시를 감당할 수 있는지는 동시 사용자 수에 따라 따로 계산해야 합니다.
실전에서 자주 생기는 문제
활성 파라미터로 서버를 산정하는 경우
발표 자료에서 490억 개만 쓴다는 숫자를 보면 서버 규모를 그 숫자로 잡기 쉬운데, 견적이나 설치 단계에서 메모리 부족이 드러납니다. 산정표에는 총 파라미터와 활성 파라미터를 나란히 적고, 메모리는 총 파라미터로, 처리 속도는 활성 파라미터로 따로 계산하면 됩니다.
GPU가 적은 환경에서 큰 MoE 모델을 고르는 경우
Hugging Face 해설은 처리량이 적고 GPU 메모리가 부족한 환경에서는 밀집 모델이 낫고, MoE는 여러 장비로 많은 요청을 처리할 때 유리하다고 정리합니다. 예를 들어 수십 명이 쓰는 부서용 문서 검색이라면, 총 파라미터가 작은 밀집 모델이 같은 GPU에서 운영하기 더 쉬울 수 있습니다. 모든 기관에 1조 파라미터 모델이 필요한 것은 아닙니다.
라이선스를 확인하기 전에 도입 일정부터 잡는 경우
가중치를 공개한다는 발표와, 기관 안에서 업무에 써도 된다는 조건은 따로 확인해야 합니다. Mistral Large 4는 라이선스 조건이 아직 자세히 나오지 않았고, 아파치 2.0으로 공개된 콜리브리와 조건이 다를 수 있습니다. 가중치가 공개되면 라이선스 문서를 직접 열어 수정, 재배포, 내부 서비스 제공이 허용되는지 법무 검토를 거친 뒤 일정을 잡습니다.
하이퍼이지의 접근
하이퍼이지는 폐쇄망 기관과 AI 도입을 논의할 때 모델 이름보다 업무와 사용 규모를 먼저 정리합니다. 어떤 업무에 쓰는지, 동시에 몇 명이 쓰는지, 한 번에 넣는 문서가 얼마나 긴지를 정한 다음에 모델 크기와 GPU를 산정합니다. 업무용 PC, 내부망 서버, 전용 인프라 중 어디서 운영할지 단계별로 나누는 방법은 망분리 AI 도입 글에서 다뤘습니다.
Skein OS는 업무 규칙과 데이터 정의를 모델 밖의 온톨로지에 둡니다. 그래서 처음에는 작은 모델로 시작했다가, MoE 대형 모델의 라이선스와 배포 형식이 확정되면 모델만 교체하는 식으로 운영합니다. 모델을 교체할 수 있는 구조가 왜 필요한지는 모델 가격과 교체 구조 글에 정리했습니다. GPU 서버를 공급하거나 모델을 직접 학습하는 일은 하이퍼이지가 맡는 범위가 아닙니다.
자주 묻는 질문
MoE 모델은 총 파라미터가 같은 밀집 모델보다 빠를까요?
토큰마다 일부 전문가만 계산하므로 연산량으로 보면 빠릅니다. 다만 전문가를 여러 GPU에 나눠 올리면 GPU 사이에 데이터를 주고받는 시간이 더해지니, 실제 속도는 서버 구성과 동시 요청 수에 따라 달라집니다.
업무용 PC에서도 MoE 모델을 쓸 수 있을까요?
총 파라미터 기준 메모리가 PC에 들어가야 합니다. 콜리브리처럼 총 781억 개인 모델도 BF16이면 가중치만 약 156GB여서 일반 업무용 PC에는 들어가지 않습니다. PC에서 쓰려면 총 파라미터가 작은 모델이나 많이 양자화한 모델을 찾아야 합니다.
정리
MoE는 여러 전문가 중 일부만 골라 계산하는 구조라서, 계산량은 활성 파라미터를 따르고 메모리는 총 파라미터를 따릅니다. 온프렘 GPU를 산정할 때 두 숫자를 따로 적고 정밀도와 동시 사용자 수까지 넣어 계산하면, 견적과 실제 운영 사이의 차이를 줄일 수 있습니다.