

N2SF 뜻: 국가망보안체계에서 공공기관이 생성형 AI를 쓰는 조건
공공기관 업무망 PC에서는 아직 생성형 AI를 쓰기 어렵습니다. 보도자료 초안을 다듬거나 간단한 검색을 하려 해도 인터넷망 PC로 자리를 옮겨야 하는 기관이 많습니다. 2026년 10월 6일 국정감사에서 행정안전부 장관은 정부망이 망분리 정책으로 인터넷망과 분리돼 있고, AI를 이용한 해킹 시도는 지금까지 없었다고 답했습니다. 같은 자리에서는 행안부 산하 한국지역정보개발원의 웹메일이 해킹돼 약 6GB 규모 데이터가 빠져나간 일도 지적됐는데, 웹메일처럼 바깥에서 접속하는 서비스는 망분리만으로 지키기 어렵습니다.
N2SF(국가망보안체계, National Network Security Framework)는 공공기관이 다루는 업무 정보를 기밀(C), 민감(S), 공개(O) 세 등급으로 나누고, 등급마다 다른 보안통제를 적용하는 보안 체계입니다. 국가정보원은 2025년 1월 23일 가이드라인 초안을 각급기관에 배포했고, 9월 9일 사이버 서밋 코리아 2025에서 정식 버전을 발표한 뒤, 9월 30일 국가사이버안보센터 홈페이지에 가이드라인 1.0을 공개했습니다. 모든 망을 똑같이 끊는 망분리 정책을 대신하고, 보안을 지키면서 생성형 AI와 클라우드를 업무에 쓸 수 있게 하려고 만든 체계입니다.
이 글에서는 N2SF가 망분리와 어떻게 다른지, 등급마다 정보를 어떻게 다루는지 정리하고, 기관이 AI 서비스를 고르기 전에 정보 분류부터 해야 하는 이유를 설명합니다.
N2SF 뜻: 망분리와 무엇이 다를까요?
공공기관은 2006년부터 업무망과 인터넷망을 물리적으로 나눠 쓰는 망분리 정책을 지켜 왔습니다. 해킹을 막는 데는 효과가 있었지만, 업무망에 있는 정보는 중요도와 상관없이 모두 같은 수준으로 묶였습니다. 이미 배포한 보도자료와 수사 기록이 같은 망 안에 있다 보니, 인터넷 연결이 필요한 생성형 AI나 클라우드는 어느 업무에도 쓰기 어려웠습니다.
N2SF는 보호 기준을 망에서 정보로 옮깁니다. 기관이 가진 정보를 중요도에 따라 나누고, 중요한 정보는 지금처럼 엄격하게 격리하되 공개해도 되는 정보는 외부 서비스와 연결해 쓰게 합니다. 가이드라인 1.0에는 제로트러스트, 오버레이, 크로스 도메인 솔루션(CDS)이 함께 반영됐습니다. 제로트러스트는 항상 검증하고 권한은 필요한 만큼만 주는 원칙이고(제로트러스트 뜻에서 자세히 다뤘습니다), 오버레이는 기관마다 다른 환경에 맞춰 기본 보안통제 위에 더하는 맞춤 지침입니다. CDS는 등급이 다른 망 사이에서 데이터를 안전하게 주고받게 하는 기술로, 양방향으로 주고받을 때는 무결성을 검증하고 악성코드를 걸러 냅니다.
C·S·O 등급별로 정보를 다루는 방식
등급은 아래처럼 나뉩니다.
| 등급 | 해당하는 정보 | 다루는 방식 |
|---|---|---|
| 기밀 (C, Classified) | 수사, 안보, 국방, 국민 생명·안전과 직결된 정보 | 기존처럼 엄격하게 격리 |
| 민감 (S, Sensitive) | 외부로 유출되면 국가나 개인에게 피해가 갈 수 있는 비공개 정보 | 보안통제를 적용한 상태에서 사용 |
| 공개 (O, Open) | 보도자료처럼 대외 공개가 가능한 정보 | 생성형 AI와 클라우드 활용 가능 |
가이드라인은 본책과 부록 두 권으로 구성됩니다. 부록1(보안통제 항목 해설서)은 권한, 인증, 분리·격리, 통제, 데이터, 정보자산 여섯 영역에 걸쳐 280여 개 보안통제 항목을 등급별로 다르게 적용하도록 설명합니다. 초안 때 170여 개였던 항목이 정식 버전에서 크게 늘었습니다. 부록2(정보서비스 모델 해설서)는 기관이 실제로 쓰는 서비스 유형을 모델로 정리했는데, 초안의 8종에서 11종으로 늘면서 생성형 AI, 무선랜, 외부 클라우드 협업이 들어갔습니다.
같은 부서 업무 안에서도 등급은 갈립니다. 예를 들어 이미 배포한 보도자료는 공개 등급이지만, 배포 전 정책 검토 문서는 민감 등급으로 분류될 수 있습니다. 보도자료 문장을 AI로 다듬는 일과 검토 문서를 AI로 요약하는 일에 적용되는 보안통제가 달라지는 셈입니다.
왜 정보 분류부터 해야 할까요?
한국인터넷진흥원(KISA)은 2025년 지식재산처, 정보통신기획평가원(IITP), 국가과학기술연구회(NST), 국가보안기술연구소(NSR) 등 6개 공공기관과 N2SF 실증을 마쳤고, 2026년 3월에는 45억 원 규모 공모 사업으로 공공기관의 N2SF 도입을 지원한다고 밝혔습니다. 같은 달 열린 설명회에서 KISA 담당 팀장은 현장이 가장 어려워하는 일로 정보 등급 분류를 들었습니다. 분류가 잘못되면 보안에 허점이 생기거나 예산이 낭비될 수 있어서, KISA는 다른 기관이 참고할 분류 사례집을 만들고 있다고 합니다.
기관이 서두를 이유도 생겼습니다. 2026년부터 공공기관 경영평가에 AI 도입 여부가 반영되고, N2SF를 도입한 기관은 국정원 보안성 평가에서 가점을 받습니다. 그래도 어떤 AI 서비스를 쓸지는 순서상 뒤에 옵니다. 가이드라인이 제시한 적용 절차는 준비, 등급분류, 위협식별, 보안대책 수립, 적절성 평가·조정 순서로 이어지고, 단계마다 책임자와 평가지표를 둡니다.
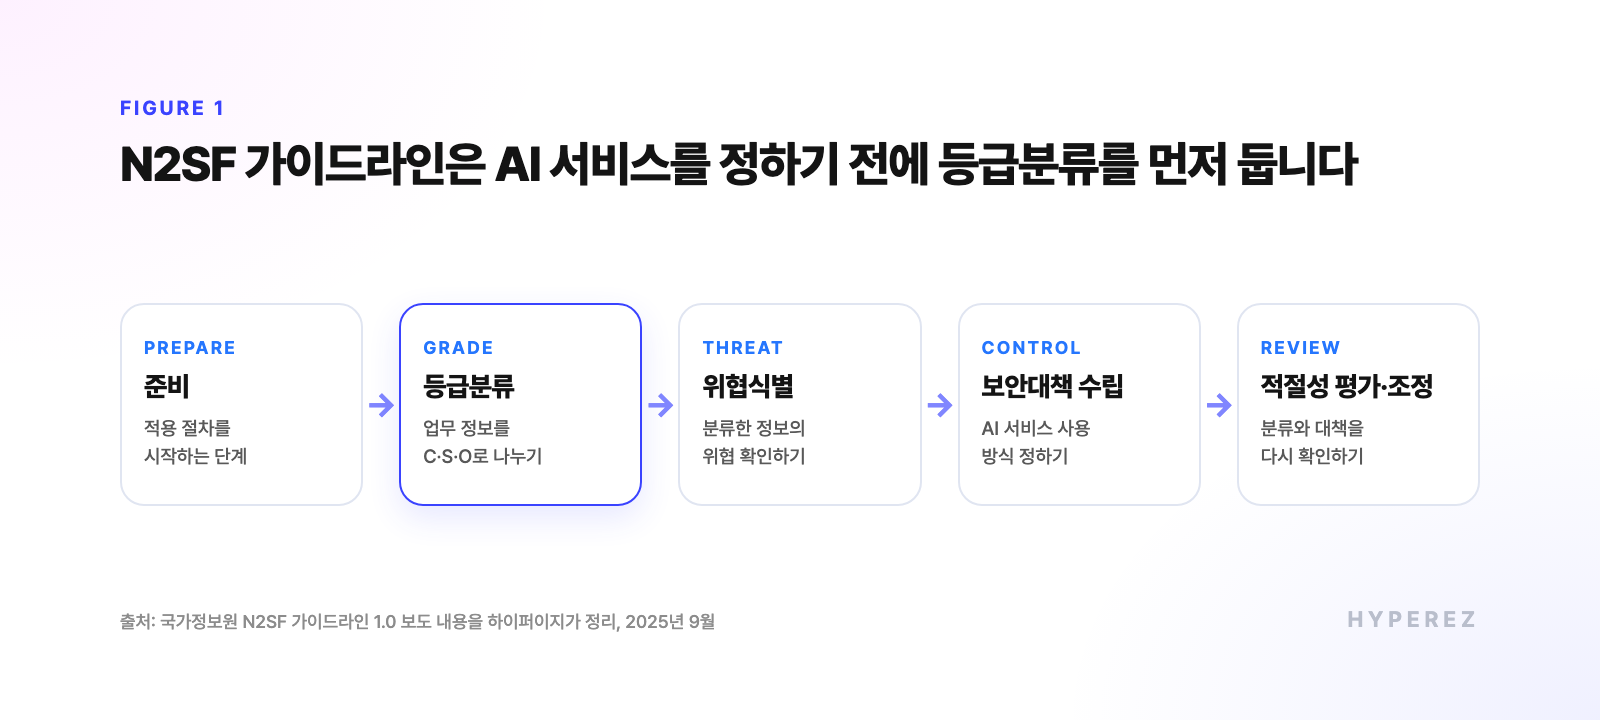
생성형 AI를 어떤 업무에 어떤 방식으로 쓸지는 보안대책 수립 단계에서 정합니다. 그 앞의 등급분류가 잘못되면 위협식별과 보안대책도 잘못된 등급을 기준으로 세우게 됩니다. 모델이나 서비스를 먼저 고르면 나중에 분류 결과에 맞춰 다시 정해야 하는 이유입니다.
현장에서 자주 생기는 문제
AI 서비스부터 고르는 경우
어떤 생성형 AI를 쓸지부터 정하고 등급분류를 나중에 하면, 고른 서비스가 다룰 수 있는 정보 범위가 분류 결과와 맞지 않는 일이 생깁니다. 공개 등급 업무에만 쓸 수 있는 서비스를 민감 등급 문서가 많은 부서에 들이면 실제로 쓸 수 있는 업무가 얼마 남지 않습니다.
시스템 단위로만 등급을 매기는 경우
한 시스템 안에도 공개 정보와 비공개 정보가 섞여 있습니다. 민원 처리 시스템이라면 처리 절차 안내문은 공개 정보지만, 민원인 개인정보와 처리 내역은 민감 정보입니다. 시스템 전체를 가장 높은 등급으로 매기면 안전해 보이지만, 공개 정보까지 AI를 쓰지 못하게 됩니다. 반대로 낮은 등급으로 매기면 보안에 허점이 생깁니다.
한 번 분류하고 다시 보지 않는 경우
정보의 등급은 시간이 지나면서 바뀝니다. 배포 전에는 민감 등급이던 정책 문서가 발표 뒤에는 공개 등급이 되기도 합니다. 가이드라인이 마지막 단계에 적절성 평가·조정을 둔 이유도 여기에 있습니다. 분류 결과와 보안대책을 주기적으로 다시 확인하는 일정까지 처음부터 정해 두는 편이 좋습니다.
하이퍼이지의 접근
하이퍼이지는 제조, 물류, 화학 분야의 폐쇄망 현장과 공군 항공기 정비 AI 운영체계(AX-MRO) 과제에서 온톨로지로 업무 대상을 먼저 정의하고, 그다음에 AI를 연결해 왔습니다. 정비 이력, 부품, 절차처럼 기관이 다루는 대상을 정의하는 일은 N2SF의 등급분류와 겹치는 부분이 많습니다. 등급을 시스템이 아니라 업무 대상에 붙여 두면, 같은 시스템 안에서도 공개 정보와 민감 정보를 나눠 다룰 수 있습니다.
Skein OS는 AI Agent가 어떤 업무 대상을 읽고 쓸 수 있는지를 온톨로지 위에서 정합니다. 기관이 정한 등급을 업무 대상에 반영하면, 에이전트의 조회 범위와 기록도 같은 기준으로 남습니다. 기관 안에서 AI를 운영하는 방식은 망분리 AI 도입 글에 정리해 두었습니다.
등급을 대신 정하거나 보안성 평가를 대행하는 일은 하이퍼이지가 맡는 범위가 아닙니다. 우리는 기관이 정한 등급이 AI를 운영하는 동안에도 지켜지도록 업무 대상과 권한을 설계하는 일을 맡습니다.
자주 묻는 질문
N2SF를 도입하면 망분리는 없어지나요?
모두 없어지지는 않습니다. 기밀 등급 정보는 지금처럼 엄격하게 격리합니다. 모든 정보를 같은 수준으로 분리하던 방식에서, 필요한 정보만 분리하는 방식으로 바뀐다고 보면 됩니다.
공개 등급 업무라면 어떤 생성형 AI든 써도 되나요?
공개 등급이라도 가이드라인의 정보서비스 모델과 보안통제 항목을 따라 보안대책을 세우고 적절성 평가를 거쳐야 합니다. 쓰려는 서비스가 기관이 정한 보안대책에 맞는지 보안 담당 부서와 먼저 확인하는 것이 좋습니다.
민간 기업과는 어떤 관계가 있을까요?
N2SF의 적용 대상은 국가·공공기관입니다. 다만 공공기관에 AI나 클라우드 서비스를 공급하는 기업은 기관이 정한 등급과 보안통제에 맞춰 서비스를 설계해야 합니다. 요구 수준은 기관과 사업마다 달라질 수 있습니다.
정리
N2SF는 망 전체를 끊던 보호 기준을 정보의 등급으로 옮긴 체계입니다. 공공기관이 생성형 AI를 쓰려면 모델을 고르기 전에 업무 정보를 기밀, 민감, 공개로 나누는 일부터 해야 하고, 그 분류가 정확할수록 AI를 쓸 수 있는 업무도 분명해집니다.