

Palantir 3분기 실적으로 본 온톨로지, 한국 기업에는 무엇이 먼저일까
11월 2일 Palantir가 발표한 2026년 3분기 실적 자료에는 회사 역사상 처음이라는 문장이 하나 들어 있었습니다. 미국 상업 매출이 미국 정부 매출을 넘었다는 내용입니다. 미국 상업 매출은 9억8,400만 달러로 1년 전보다 148% 늘었고, 미국 정부 매출은 9억5,300만 달러로 96% 늘었습니다.
분기 전체 매출은 23억1,300만 달러였고, Palantir는 연간 매출 전망을 85억3,000만 달러에서 85억3,400만 달러 사이로 올렸습니다.
3분기 실적에서 읽을 수 있는 변화
Palantir는 미국 정부와 국방 고객에게서 성장한 회사입니다. 이번 분기에도 미국 정부 매출이 96% 늘어 정부 사업도 함께 커졌는데, 기업 고객 매출은 그보다 더 빠르게 늘었습니다. 앞으로 받을 미국 상업 계약 잔액도 65억1,700만 달러로 1년 전보다 79% 늘었다고 밝혔습니다.
국방에서 먼저 쓰인 온톨로지 플랫폼이 기업 운영으로 넓어지고 있다는 신호로 읽을 수 있습니다. 같은 주 Snowflake도 11월 3일 서울에서 연 미디어 라운드테이블에서, 담당 부서가 승인한 정의를 기준으로 답하는 비즈니스 온톨로지를 환각을 줄이는 수단으로 소개했습니다. 온톨로지 플랫폼 글에서 정리했듯, Palantir, Databricks, Snowflake, Microsoft는 이미 지난 15개월 사이에 모두 온톨로지 기능을 갖췄습니다.
다만 실적 자료는 회사가 직접 낸 것이고, 분기 하나의 수치입니다. 상업 매출이 정부 매출을 계속 앞설지는 다음 분기 실적까지 확인해야 합니다.
한국 기업 현장에서 먼저 생기는 문제
하이퍼이지도 국방과 기업 현장에서 함께 일합니다. 공군의 항공기 정비 AI 운영체계(AX-MRO) 구축 과제를 주관하고 있고, 포스코DX의 기술 협력사로 철강, 화학, 물류 대기업의 DX 프로젝트에 참여해 왔습니다.
두 현장에서 온톨로지를 정의하며 가장 시간이 많이 드는 일은 도구 설치보다 정의를 합의하는 일입니다. 같은 제품을 영업팀과 생산팀이 다른 이름으로 부르고, 문서로 남긴 적 없는 예외 규칙은 베테랑 직원만 알고 있는 경우가 많습니다. 이런 상태에서 플랫폼부터 도입하면 온톨로지에 채울 내용이 없어, 데이터를 연결해 놓고도 AI가 답을 내지 못합니다.
국내 기업에는 조건이 하나 더 있습니다. 설계 도면과 원가 정보를 외부 클라우드로 내보낼 수 없는 경우가 많아, 클라우드를 전제로 만든 해외 플랫폼은 PoC까지만 진행되고 본사업에서는 쓰지 못하는 일이 생깁니다.
하이퍼이지가 도구보다 먼저 정하는 기준
그래서 하이퍼이지는 고객사와 일을 시작할 때 도구보다 다음을 먼저 정합니다.
- 먼저 풀 업무: 온톨로지를 어느 업무에 먼저 쓸지, 그 업무에서 AI가 어떤 질문에 답해야 하는지
- 정의하는 사람: 업무 대상과 규칙을 누가 정의하고 누가 승인하는지
- 정의를 소유하는 곳: 정의한 온톨로지를 고객사가 소유하고, 플랫폼을 바꿔도 가져갈 수 있는지
- 배포 위치: 민감 데이터를 외부로 내보내지 않고 온프레미스나 하이브리드로 운영할 수 있는지 Skein OS에 온톨로지와 별도로 지식 사전(Knowledge Dictionary)을 둔 것도 정의하는 사람을 정하는 일 때문입니다. 부서마다 다르게 쓰는 용어를 온톨로지의 업무 대상과 연결해 두면, 정의를 합의하는 과정이 기록으로 남고 규칙이 바뀐 이력도 확인할 수 있습니다.
업무를 먼저 고르면 회사 전체의 온톨로지를 한 번에 만들 필요도 없습니다. 같은 질문에 늘 같은 답이 나와야 하는 업무 하나에 필요한 대상과 규칙부터 정의하면 됩니다.
Palantir의 이번 분기 숫자는 온톨로지가 국방 밖에서도 쓰인다는 근거가 하나 더 생겼다는 뜻입니다. 한국 기업 현장에서 같은 일이 일어나려면 플랫폼을 고르기 전에, 온톨로지를 어느 업무에 먼저 쓸지, 그 업무의 기준을 누가 정의하고 어디에 둘지부터 정해야 합니다.
관련 글
임베딩 모델 뜻: RAG 검색 품질을 좌우하는 부품과 폐쇄망에서 고르는 기준
임베딩 모델은 문장과 문서를 벡터로 바꿔 뜻이 비슷한 글끼리 가까운 위치에 놓는 AI 모델이고, RAG에서는 답변 모델에 넘길 문서를 고르는 단계를 맡습니다. 임베딩의 뜻과 RAG 안에서 하는 일을 정리하고, 외부 API를 쓸 수 없는 폐쇄망 기관이 임베딩 모델을 고를 때 확인할 기준을 살펴봅니다.
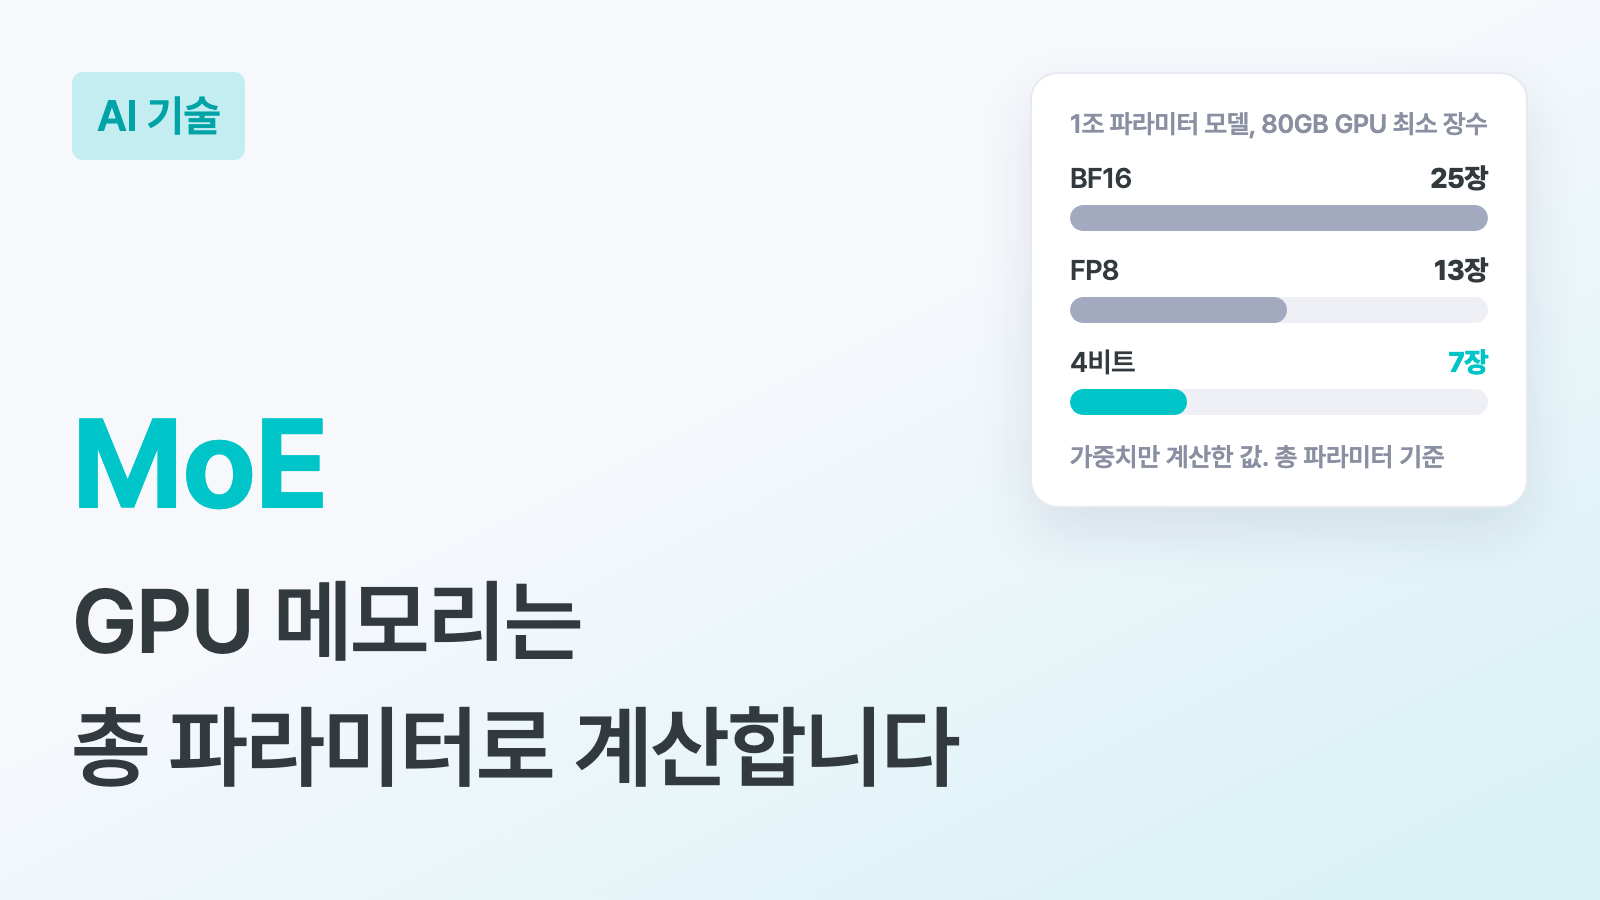
MoE 뜻: 총 파라미터와 활성 파라미터, 온프렘 GPU 산정 기준
MoE는 모델 안에 여러 전문가 신경망을 두고 토큰마다 일부만 골라 계산하는 구조입니다. 계산량은 활성 파라미터를 따르지만, GPU 메모리에는 전체 가중치를 올려야 합니다. 총 1조 파라미터 중 490억 개만 활성화하는 Mistral Large 4를 예로, 온프렘 GPU를 산정할 때 따로 계산해야 할 것을 정리합니다.
RAG 운영 단계에서 정확도가 떨어지는 이유 4가지
사내 문서 RAG는 며칠이면 만들 수 있지만, 실제 업무에 쓰기 시작하면 잘못된 답이 나옵니다. 원인은 대부분 모델보다 문서 상태에 있습니다. 운영 단계에서 정확도가 떨어지는 네 가지 원인과 판단이 필요한 질문을 규칙에 맡기는 방법, Ground Truth를 먼저 정리해야 하는 이유를 다룹니다.