

RAG 운영 단계에서 정확도가 떨어지는 이유 4가지
사내 문서를 연결한 AI 챗봇은 데모 때 반응이 좋습니다. 규정집과 매뉴얼 몇백 개를 넣고 질문하면, 그럴듯한 답이 근거 문서와 함께 나오기 때문입니다. 그런데 실제 업무에 쓰기 시작하고 한두 달이 지나면 "답이 이상하다"는 말이 나옵니다. 모델을 바꾸고 프롬프트를 고쳐 봐도 크게 나아지지 않습니다.
RAG(검색 증강 생성)는 AI가 답하기 전에 사내 문서를 검색해 근거로 붙이는 방식입니다. 데모까지는 며칠이면 만들 수 있는데, 운영 단계에서 정확도가 떨어지는 원인을 따라가 보면 대부분 모델보다 문서 상태에 있습니다. 2월에 쓴 Ground Truth와 온톨로지 글에서는 "RAG로 문서를 붙인다고 풀리는 문제가 아니다"라고만 적었는데, 이번에는 그 이유를 하나씩 알아 보려고 합니다.
운영 단계에서 정확도가 떨어지는 원인
VentureBeat는 2026년 9월 27일 기술 기고에서 기업이 RAG를 실제 업무에 쓸 때 생기는 문제를 정리했습니다. 목록에 모델 성능 이야기는 거의 없습니다. 대부분 검색 대상 문서가 어떤 상태인지에 관한 문제입니다. 그중 자주 겪는 원인을 골랐습니다.
부서마다 다른 제품 이름
영업 문서에는 "A200 모듈", 생산 문서에는 품번 "A-200-K", 고객 응대 기록에는 "신형 모듈"이라고 적혀 있다고 해 봅시다. 사람은 셋이 같은 제품인 걸 알지만, 검색 시스템은 구분하지 못합니다. 질문에 쓴 이름과 가장 비슷한 문서만 찾아오니, 같은 질문을 해도 부서마다 다른 답을 받게 됩니다.
개정 전 문서
규정이 바뀌면 새 문서가 올라오지만, 예전 문서도 대개 그대로 남아 있습니다. 검색 시스템은 어느 쪽이 현재 유효한지 알지 못합니다. 개정 전 할인율이나 폐지된 절차가 근거로 같이 나오면, 답은 그럴듯하게 나오지만 결국 사실과 다른 내용이 나올 수밖에 없습니다.
표와 스캔 문서
업무에 필요한 숫자는 문장보다 표에 많이 들어 있습니다. 단가표, 사양표, 점검 기록 같은 것들입니다. 표를 텍스트로 바꾸다가 행과 열이 어긋나거나 스캔 PDF에서 숫자를 잘못 읽으면, 문서는 제대로 찾았다고 해도 숫자가 잘못된 답이 나옵니다.
문서 열람 권한
직원마다 볼 수 있는 문서가 다른데, 검색한 문서를 AI에 그대로 넘기고 답에서 민감한 부분만 지우는 방식은 위험합니다. VentureBeat 기고도 권한 확인은 문서를 AI에 넘기기 전에 해야 하고, 답이 나온 뒤에 걸러 내면 이미 늦다고 지적합니다. 에이전트에게 권한을 주는 방식은 에이전트 권한 관리 글에서 따로 다뤘습니다.
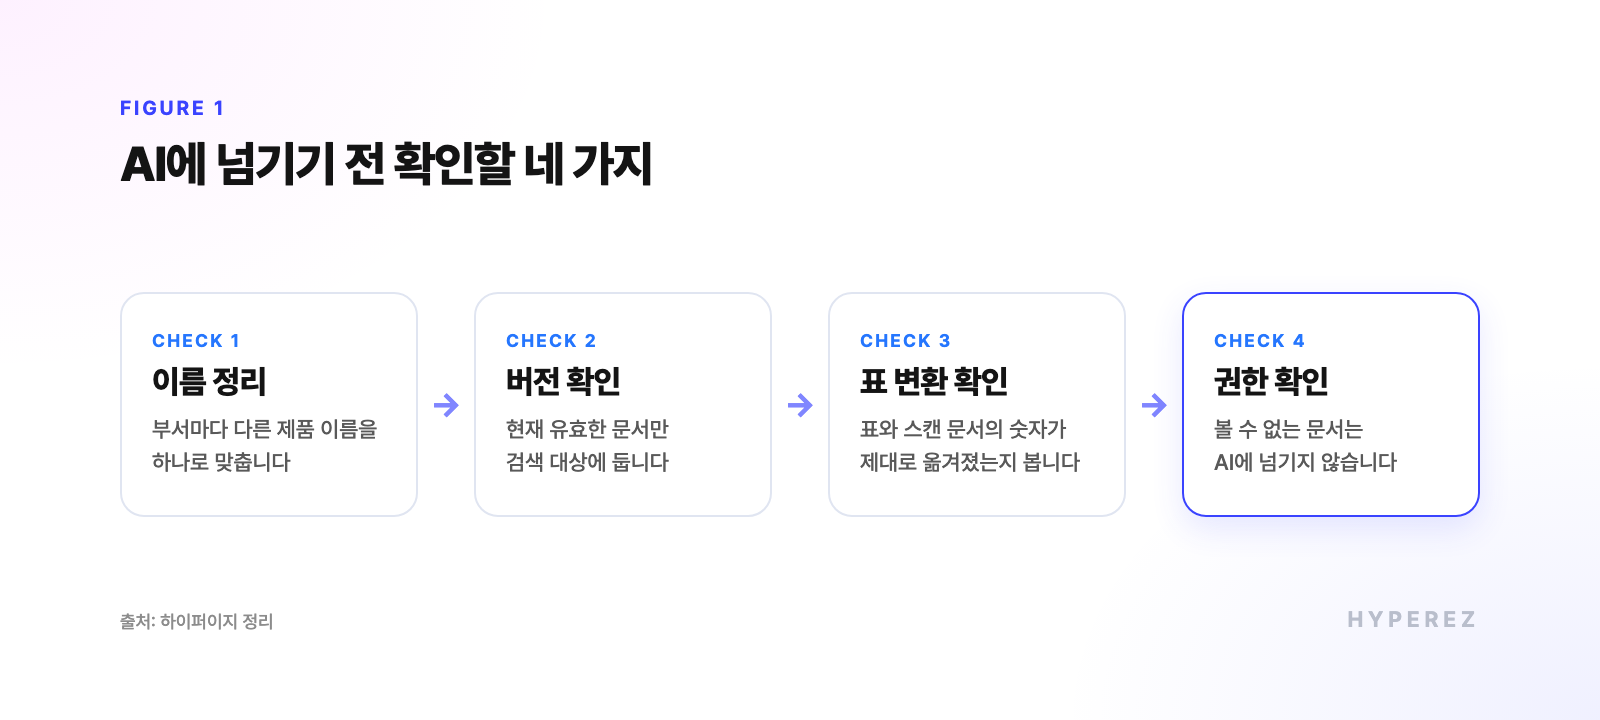
모두 문서를 AI에 넘기기 전에 정리해야 하는 일입니다. 모든 문서를 한 번에 정리할 필요는 없습니다. 잘못된 답이 나왔을 때 손해가 큰 문서(가격, 계약 조건, 안전 절차)부터 이름과 버전을 맞추는 것만으로도 효과가 큽니다.
검색으로 답하면 안 되는 질문은?
RAG에 맞는 질문이 있고, 맞지 않는 질문이 있습니다. "출장비 규정이 어디 있나요?"는 검색으로 충분합니다. 반면 "이 대출을 승인해도 되나요?", "이 거래는 사기인가요?"처럼 나중에 감사를 받아야 하는 판단은 검색 결과를 조합해 답하면 곤란합니다. 같은 조건이면 언제나 같은 판정이 나와야 하고, 왜 그렇게 판정했는지 설명할 수 있어야 하기 때문입니다.
2026년 9월 Hacker News에 공개된 한 오픈소스 프로젝트는 역할을 나눠 이 문제를 풀었습니다. YAML로 적은 규칙에 따라 룰 엔진이 판정을 내리고, LLM은 관련 규정 문서를 찾아 판정 이유만 설명합니다. LLM이 판정을 바꿀 수는 없습니다. 작성자는 대출, 사기 탐지, 임상 분류처럼 감사가 필요한 판단을 LLM에 맡겨 놓고 안전장치를 나중에 덧붙이는 팀을 여러 번 봤고, 그래서 이 프로젝트를 만들었다고 밝혔습니다.
2월 글에서 소개한 온톨로지의 규칙("미결제 주문은 출고할 수 없다" 같은 제약)이 바로 이런 판정에 쓰입니다. 규칙이 정해져 있으면 LLM은 계산된 결과를 사람이 읽기 쉬운 말로 풀어 주는 역할만 하면 됩니다.
전문가가 정리한 지식을 쓰는 사례
이름과 규칙을 정리해 둔 지식에 에이전트를 연결하는 기업도 있습니다. 생명과학 기업 Qiagen은 2026년 9월 28일 그래프 데이터베이스 기업 Neo4j의 GraphSummit 행사에서, 의학·박사급 전문가 150명 이상이 25년 넘게 직접 정리한 지식 기반에 MCP로 신약 탐색 에이전트를 연결하고 있다고 소개했습니다(자사 플랫폼을 소개하는 발표였다는 점은 감안해서 볼 필요가 있습니다). 발표자인 Iman Bhattacharya는 정리되지 않은 자료만 주면 에이전트가 어떻게 되는지 이렇게 말했습니다.
Your agent will start to provide output, and it will hallucinate. It will never say no.
에이전트는 모른다고 답하지 않습니다. 그래서 근거 자료를 누가 어떤 기준으로 정리했는지에 따라 답을 믿을 수 있는지가 갈립니다. 25년 동안 쌓은 지식 기반은 흔치 않지만, 우리 회사의 가격표와 제품 목록을 누가 관리할지 정하는 일은 어느 기업이나 할 수 있습니다.
실전에서 자주 하는 실수
청크 크기 조정에만 매달리는 경우
답이 부정확하면 문서를 자르는 단위(청크) 크기나 임베딩 모델부터 바꿔 보는 경우가 많습니다. 효과가 있을 때도 있지만, 원인이 제품 이름이나 개정 전 문서라면 몇 번을 조정해도 같은 질문에서 계속 오답이 나옵니다. 오답 열 개를 모아 원인부터 분류해 보는 편이 빠릅니다.
벡터 검색만 쓰는 경우
의미가 비슷한 문서를 찾는 벡터 검색은 품번이나 규정 번호처럼 정확히 일치해야 하는 검색에 약합니다. 키워드 검색과 메타데이터 필터(부서, 유효 기간, 문서 등급)를 함께 쓰는 쪽이 실제 운영에서는 더 안정적입니다.
문서 관리 담당자가 없는 경우
RAG를 도입하고 나서 가장 늦게 드러나는 문제입니다. 문서가 바뀌었을 때 누가 검색 색인을 갱신하고 예전 문서를 내릴지 정해 두지 않으면, 답의 정확도는 도입 첫 달이 가장 높고 그 뒤로 조금씩 떨어집니다.
하이퍼이지는 어디를 맡나요?
하이퍼이지는 문서가 AI에 들어가기 전에, 어떤 이름이 같은 대상을 가리키는지와 어떤 규정이 현재 유효한지를 정의하는 일을 주로 맡습니다. Skein OS에는 현장에서 쓰는 용어와 온톨로지 엔티티를 연결하는 지식 사전(Knowledge Dictionary)이 있습니다. "A200 모듈"과 "A-200-K"가 같은 제품이라고 한 번 정의해 두면, 어느 부서에서 어떤 이름으로 물어도 같은 제품을 찾습니다. 규칙 변경 이력도 자동으로 기록해서, 개정 전 규정이 현재 규정처럼 쓰이지 않게 합니다.
어떤 문서를 기준으로 삼을지, 누가 관리할지는 결국 고객사가 정합니다. 하이퍼이지의 FDE는 현장에서 그 기준을 함께 정하고, 정한 기준이 시스템에 반영되도록 돕습니다.
자주 묻는 질문
Ground Truth는 무슨 뜻인가요?
기업 안에서 누가 물어도 같은 답이 나와야 하는 사실을 말합니다. 주문 상태, 적용 할인율, 자재가 쓰이는 공정 같은 것들입니다. RAG가 문서에서 답을 찾아오는 방식이라면, Ground Truth는 그 답이 맞는지 판단하는 기준입니다.
RAG와 온톨로지 중 무엇부터 해야 하나요?
둘 중 하나만 골라야 하는 건 아닙니다. 규정 찾기처럼 문서를 찾아 보여 주면 되는 업무는 RAG부터 시작해도 됩니다. 가격 계산이나 출고 판단처럼 매번 같은 답이 나와야 하는 업무는 이름과 규칙을 먼저 정해 두는 편이 결국 더 빠릅니다.
문서가 많지 않은 회사도 이런 준비가 필요한가요?
문서가 얼마나 많은지보다 잘못된 답이 나왔을 때 손해가 얼마나 큰지가 기준입니다. 문서가 수백 개뿐이어도 가격이나 계약 조건을 다룬다면, 버전과 권한은 처음부터 정해 두는 게 좋습니다.
정리
데모 때 정확하던 답이 운영에서 부정확해지는 이유는 대부분 문서 상태에 있습니다. 제품 이름을 맞추고, 개정 전 문서를 걸러 내고, 권한을 먼저 확인하고, 판단이 필요한 질문은 규칙에 맡기면 모델을 바꾸지 않아도 답이 훨씬 정확해집니다. 새 모델을 기다리기 전에 지금 어떤 문서가 어떤 상태로 들어가고 있는지부터 확인해 보는 편이 좋습니다.